はじめに
機械学習では、学習に使うデータを1か所へ集めてモデルを訓練する方法が一般的です。しかし、スマートフォンの入力履歴や組織ごとに保有するデータのように、機密性や管理上の理由から元データを中央へ集めにくい場合があります。
連合学習(Federated Learning)は、学習データを各端末や組織に保持したまま、そこで計算したモデル更新情報を集約して共有モデルを学習する方式です。この記事では、基本的な仕組み、中央集約型学習との違い、利点と課題、プライバシー保護との関係を解説します。
この記事で分かること
- 連合学習とはどのような機械学習方式か
- データを中央へ集めずに共有モデルを学習する基本的な流れ
- 連合学習の利点・課題と、プライバシー保護との正しい関係
連合学習とは
連合学習とは、複数の端末や組織が手元のデータでモデルを学習し、その更新情報を集約して共有モデルを改善する機械学習方式です。典型的には、サーバーが共有モデルを参加者へ配布し、各参加者がローカル学習した更新情報を返し、サーバーがそれらを集約します。
重要なのは、学習に使う生データそのものを中央の学習用データセットへ集約しない点です。ただし、「生データを集めない」ことと「情報が絶対に漏れない」ことは同じではありません。連合学習はデータを分散保持できる仕組みですが、プライバシーを保証するためには別の保護策も考える必要があります。
連合学習は、教師あり学習・教師なし学習・強化学習と同じ分類軸ではありません。教師あり学習・教師なし学習・強化学習は、正解ラベルや報酬など「何を手掛かりに学ぶか」を表すのに対し、連合学習は「データをどこに置き、複数の参加者でどう共同学習するか」を表します。教師あり・教師なしの違いは教師あり学習と教師なし学習の違いとは?特徴と使い分けをわかりやすく解説、強化学習は強化学習とは?報酬から行動を学ぶ仕組みをわかりやすく解説で整理しています。
連合学習の仕組み
連合学習では、共有モデルの配布、ローカル学習、更新情報の送信、集約という処理を繰り返します。基本的な流れは次のとおりです。
- サーバーが現在の共有モデルを参加する端末や組織へ配布する。
- 各参加者が、手元に保持しているローカルデータを使ってモデルを学習する。
- 各参加者が、学習によって得られた重みの差分などのモデル更新情報をサーバーへ送る。
- サーバーが複数の更新情報を集約して共有モデルを更新し、必要な回数だけ同じ流れを繰り返す。
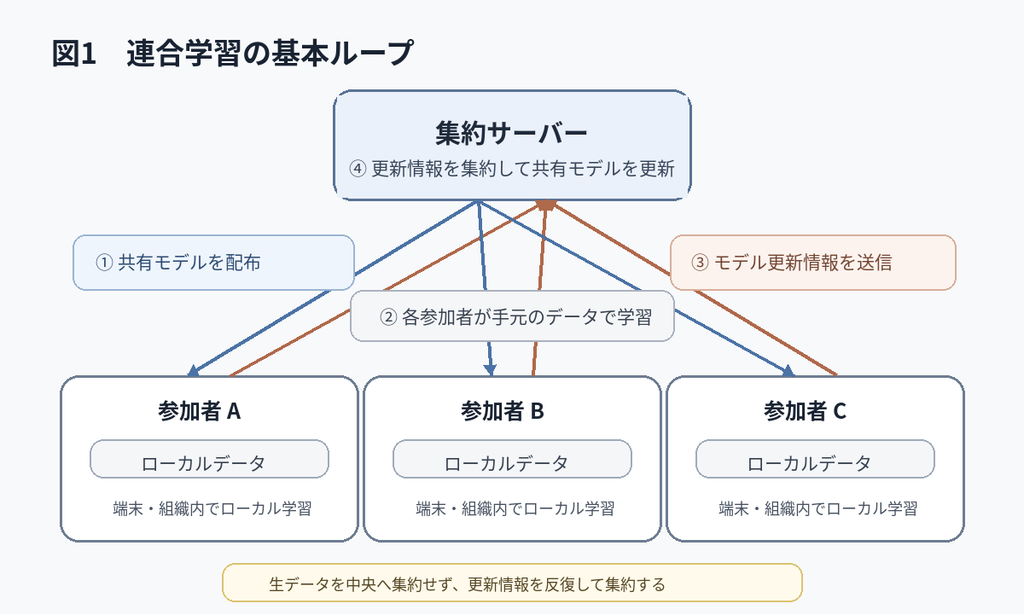
この方法では、サーバーが各参加者の生データを直接使って学習するのではなく、各参加者がローカルで計算した更新情報を使って共有モデルを改善します。実際の連合学習では、毎回すべての参加者が参加するとは限らず、参加可能な端末の選択や通信状況への対応も必要になります。
中央集約型学習との違い
連合学習と中央集約型学習の大きな違いは、学習データをどこに置くかです。
| 観点 | 中央集約型学習 | 連合学習 |
|---|---|---|
| 学習データ | サーバー側へ集約して学習する | 各端末・組織に保持したまま学習する |
| サーバーが主に受け取るもの | 学習用のデータ | モデル更新情報 |
| データ管理 | 中央で一元管理しやすい | 複数の参加者に分散する |
| 通信 | データ収集時の転送が必要 | 学習中にモデルの配布・更新送信を繰り返す |
| 主な課題 | データ集中による管理・漏洩リスク | 通信、参加者ごとのデータ差、端末差、更新情報の保護 |
連合学習では元データを中央へ集めないため、データ集中を避けられます。一方で、モデル更新情報を何度も送受信するため、通信が不要になるわけではありません。通信量や通信回数は連合学習の主要な設計課題の一つです。
連合学習の利点
連合学習の主な利点は、元データを中央へ集めずに、そのデータを学習へ利用できることです。端末内にある入力履歴や、組織ごとに管理するデータなど、中央集約が難しいデータから共有モデルを学習できる可能性があります。
また、生データを一か所へ集める必要を減らせるため、中央に大量の個別データを保管するリスクや管理負担を抑えやすくなります。複数の参加者がデータ管理境界を保ちながら、同じ共有モデルの改善に参加できることも特徴です。
ただし、「必ず安全」「必ず通信量が減る」わけではありません。効果は参加者数、モデルの大きさ、通信方式、データ分布、追加の保護策などによって変わります。
連合学習の課題
連合学習では、データが分散していること自体が学習の難しさにつながります。代表的な課題は次のとおりです。
- データの偏り:参加者ごとにデータ量や傾向が異なる非IIDデータでは、共有モデルの学習が不安定になったり、特定の参加者に合いにくくなったりすることがある。
- 通信負荷:モデルの配布と更新情報の送信を繰り返すため、回線速度や通信回数が学習時間の制約になりやすい。
- 端末・参加状況の違い:計算性能、バッテリー、ネットワーク状況が異なり、途中で参加できなくなる端末もある。
- セキュリティ:悪意ある参加者が不正な更新情報を送るモデル汚染や、更新情報から元データに関する情報を推測されるリスクを考える必要がある。
このため、学習アルゴリズムだけでなく、通信、参加者管理、集約方法、セキュリティまで含めた設計が必要です。
連合学習とプライバシー保護の関係
連合学習は、生データを中央へ送る必要を減らしながら、そのデータを学習へ利用できる方式です。しかし、モデル更新情報にも学習データの特徴が反映されるため、更新情報を送るだけでプライバシーが自動的に保証されるわけではありません。
そこで、サーバーが各参加者の個別更新を直接見ず集約値だけを得るSecure Aggregationや、個々の参加者の影響を推測しにくくするDifferential Privacy(差分プライバシー)などを組み合わせることがあります。連合学習は「データをどこで学習するか」を決める方式、これらは情報漏洩リスクをさらに抑えるための保護手段として分けて理解すると整理しやすくなります。
また、技術的に生データを中央へ集めないことと、データ利用に必要な法令遵守や利用目的、ユーザー許諾を満たすことも別の問題です。データ活用時の法令・プライバシー・許諾についてはデータ活用の倫理ルール:法令と許諾を守る方法を解説で整理しています。
連合学習の利用例
連合学習の代表例として、スマートフォンのキーボードがあります。Google Researchは、Gboardの次単語予測用言語モデルで連合学習を利用し、Differential Privacyを組み合わせた言語モデルも実運用したと報告しています。端末上のデータをそのままサーバーへ送らずに学習へ利用する、連合学習の代表的な活用例です。
連合学習は、複数の場所に学習に役立つデータがあり、生データを中央へ集約しにくい場面に向きます。スマートフォンのような多数の端末だけでなく、異なる組織がデータ管理を維持しながら共同モデルを学ぶ構成にも利用できます。
まとめ
連合学習は、複数の端末や組織が手元のデータでローカル学習し、そのモデル更新情報を集約して共有モデルを改善する機械学習方式です。生データを中央へ集約しないことが大きな特徴ですが、通信が不要になるわけではなく、非IIDデータ、端末差、参加状況、セキュリティなど固有の課題があります。
また、連合学習そのものをプライバシー保証と考えるのは適切ではありません。生データを中央へ集めない設計に加えて、必要に応じてSecure AggregationやDifferential Privacyなどを組み合わせることで、プライバシー保護を強化します。「データを分散したまま、どう共同学習するか」を理解することが、連合学習を正しく捉えるポイントです。
関連記事

