はじめに
変数が2つ程度なら散布図や棒グラフで関係を確認できますが、売上・客数・客単価・広告費のように複数の変数を同時に見ると、1つのグラフだけでは特徴を捉えにくくなります。
多変量データの可視化では、「どの手法が最も優れているか」ではなく、「何を知りたいかに応じて手法を選ぶ」ことが重要です。この記事では、同じ店舗データを平行座標、散布図行列、相関ヒートマップ、Table Lensの考え方で見比べ、各手法で何が見えやすく、何が見えにくいかを解説します。
この記事で分かること
- 多変量データを可視化する目的
- 平行座標、散布図行列、ヒートマップ、Table Lensの違い
- 同じデータでも可視化手法によって見える特徴が変わる理由
- 目的に応じた可視化手法の選び方
多変量データの可視化とは
多変量データとは、1つの対象について複数の変数を持つデータです。たとえば店舗ごとに「売上」「客数」「客単価」「広告費」がある場合、1店舗を4つの変数で表せます。
この記事では、次のような12店舗の合成データを例にします。実在する店舗のデータではなく、可視化手法の違いを説明するために作成したデータです。
| 店舗 | 売上(万円) | 客数 | 客単価(千円) | 広告費(万円) |
|---|---|---|---|---|
| 店舗1 | 820 | 420 | 19.5 | 48 |
| 店舗2 | 740 | 330 | 22.4 | 62 |
| 店舗3 | 690 | 390 | 17.7 | 35 |
| 店舗4 | 910 | 445 | 20.4 | 58 |
| 店舗5 | 635 | 300 | 21.2 | 31 |
| 店舗6 | 570 | 365 | 15.6 | 28 |
| 店舗7 | 770 | 350 | 22.0 | 42 |
| 店舗8 | 845 | 410 | 20.6 | 36 |
| 店舗9 | 660 | 285 | 23.2 | 55 |
| 店舗10 | 795 | 375 | 21.2 | 47 |
| 店舗11 | 545 | 260 | 21.0 | 24 |
| 店舗12 | 705 | 315 | 22.4 | 92 |
このデータでは、店舗4は売上と客数が高く、店舗12は広告費が最大ですが売上は最大ではありません。こうした特徴が、可視化手法によってどう見えるかを比べます。
同じ多変量データを4つの方法で見る
平行座標:1つの対象の「プロフィール」をまとめて見る
平行座標では、変数ごとに軸を並べ、1つの観測対象を各軸上の値を結ぶ1本の線として表します。高次元データを1枚で眺められるため、店舗ごとの複数指標の組み合わせを比較したいときに便利です。
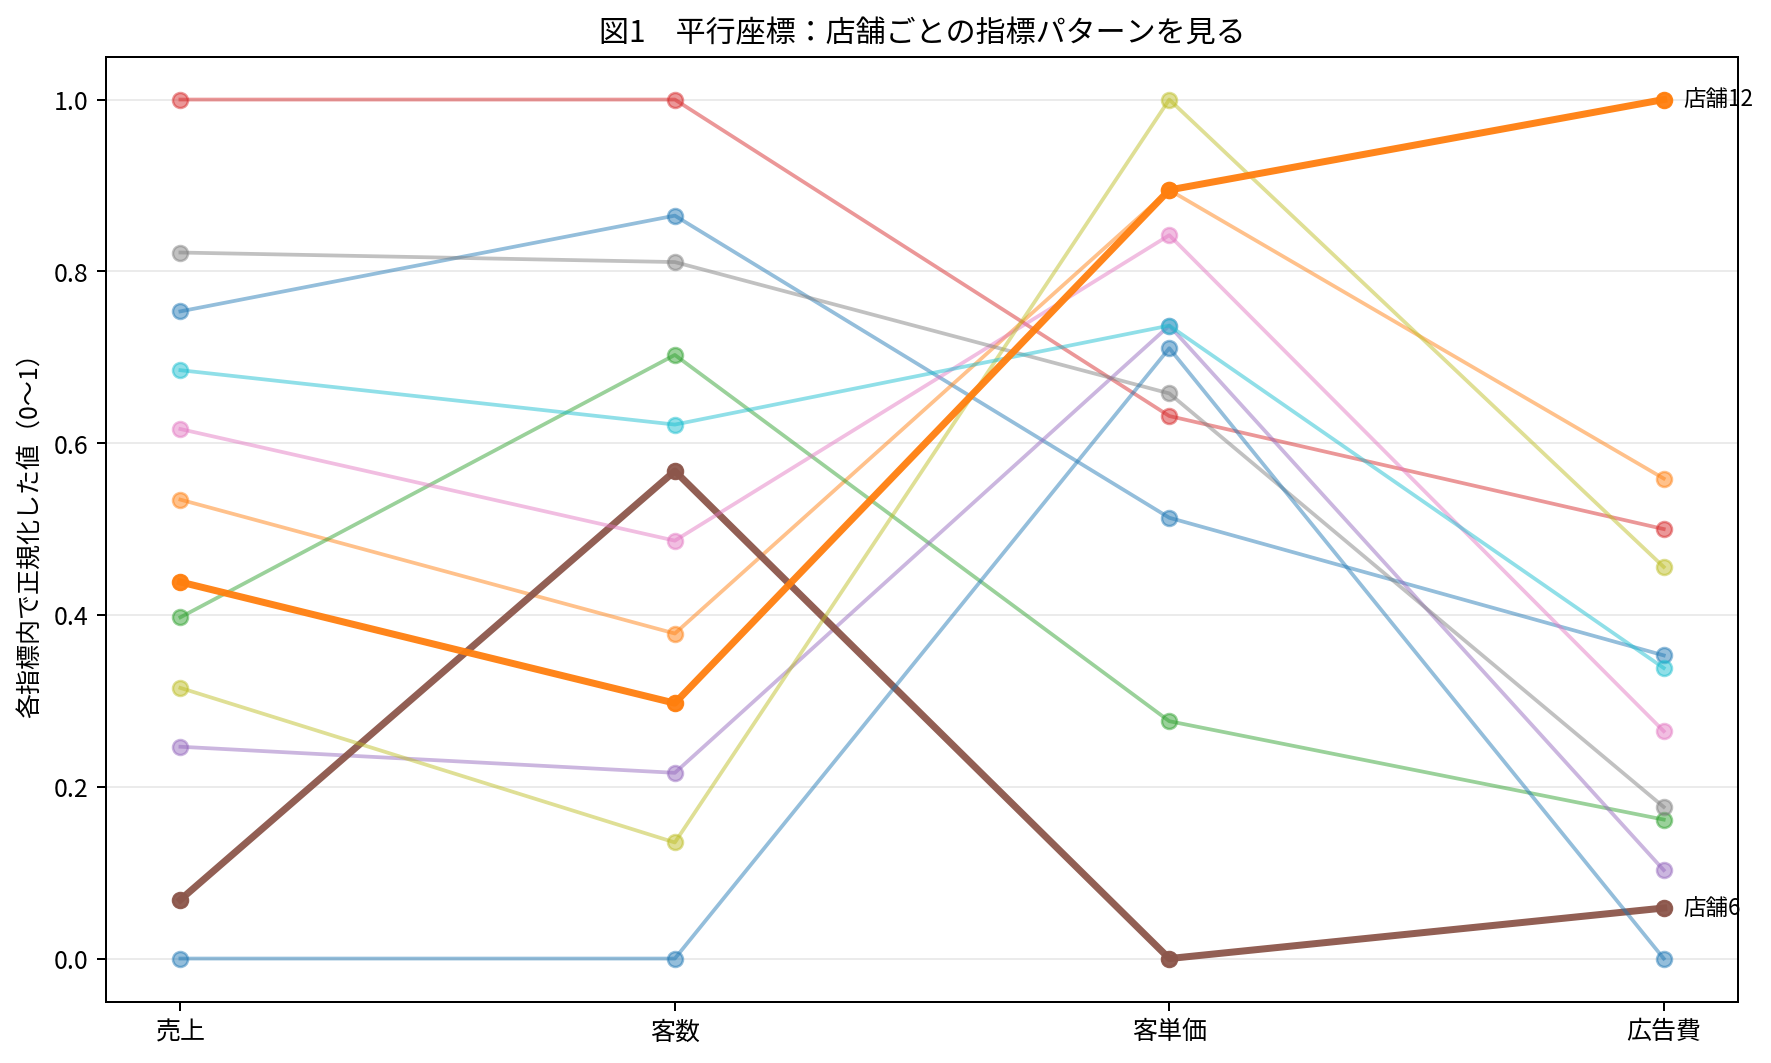
図1では、売上・客数・客単価・広告費を0〜1へ正規化して並べています。店舗12のように広告費だけが突出している店舗や、店舗6のように客数に対して客単価が低い店舗は、線の形を見ることで気付きやすくなります。
一方で、線が増えるほど重なりが多くなり、読み取りにくくなります。また、隣り合う軸の順序によって関係が見えやすくなったり見えにくくなったりする点にも注意が必要です。
散布図行列:変数同士の関係をペアごとに見る
散布図行列は、複数の変数について、すべての変数ペアの散布図を行列状に並べたものです。2変数の関係を一つずつ確認しながら、全体をまとめて見渡せます。
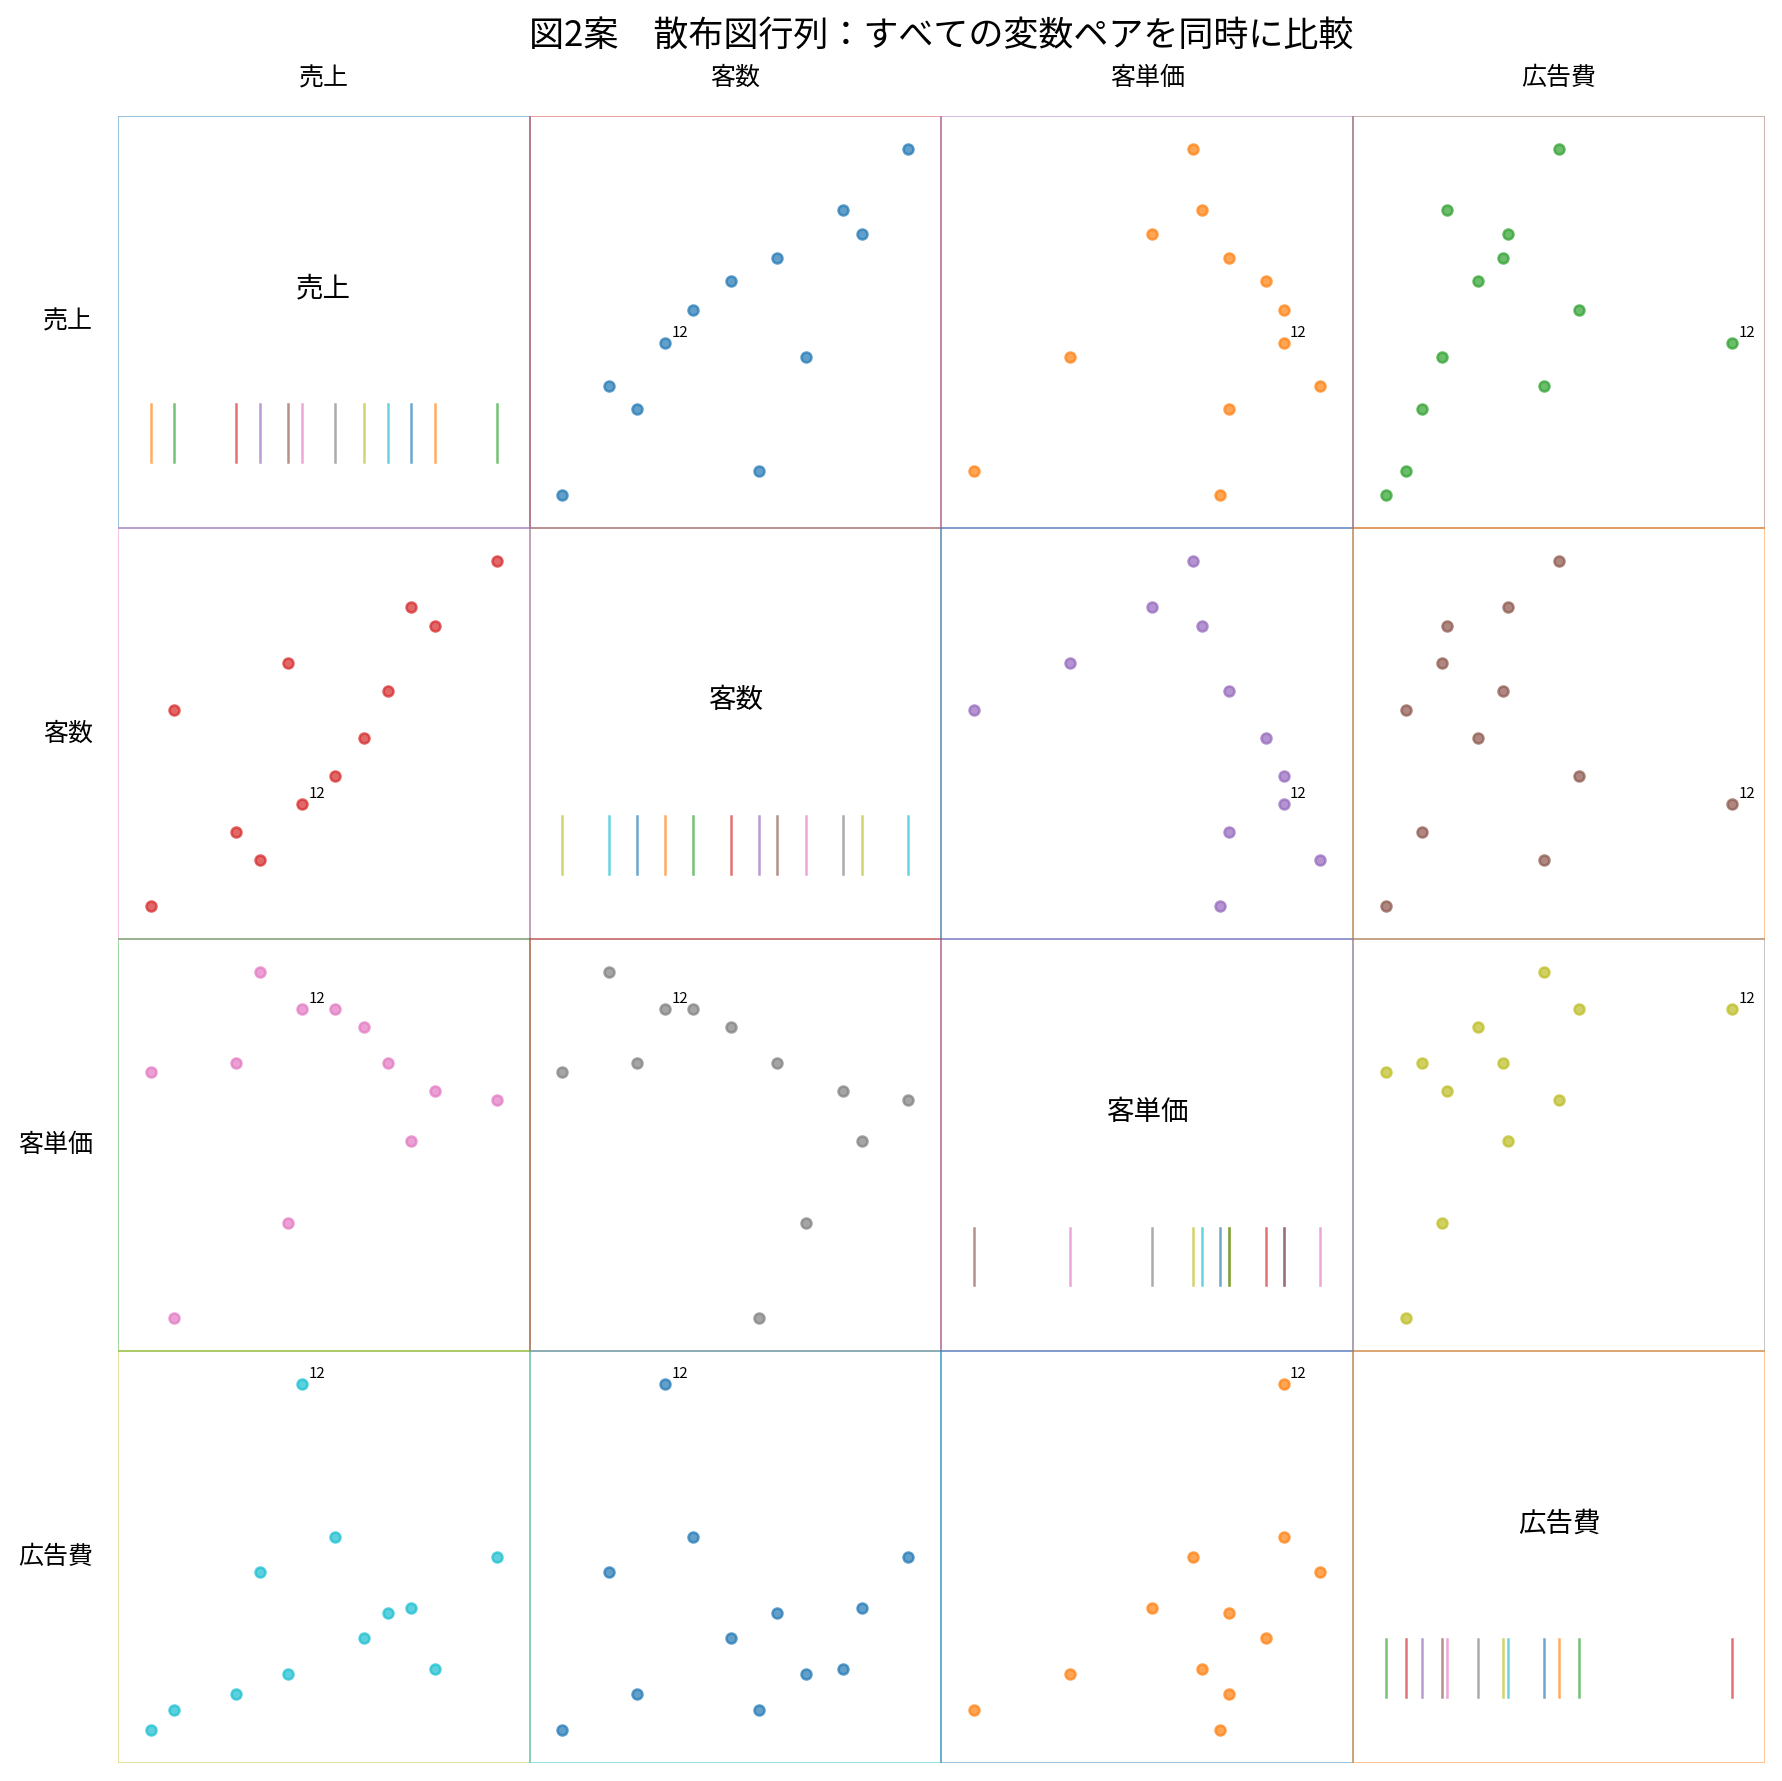
図2では、売上と客数には正の関係が見られる一方、客数と客単価では異なる傾向が見えます。また、店舗12は広告費の散布図で他店舗から離れた位置に現れます。
散布図行列は、相関の方向、外れた観測値、非線形な関係などを実際の点の分布から確認しやすいのが長所です。ただし、変数が増えると必要な散布図の数が急速に増え、全体が大きくなります。
なお、散布図行列の対角部分は必ずヒストグラムになるわけではありません。変数名、ヒストグラム、分布図、空欄など、実装や目的に応じた表現が使われます。
相関ヒートマップ:変数全体の関係を一目で比較する
相関ヒートマップでは、変数同士の相関係数などを色で表します。多数の変数について「どの組み合わせの関係が強いか」を短時間で俯瞰したいときに向いています。
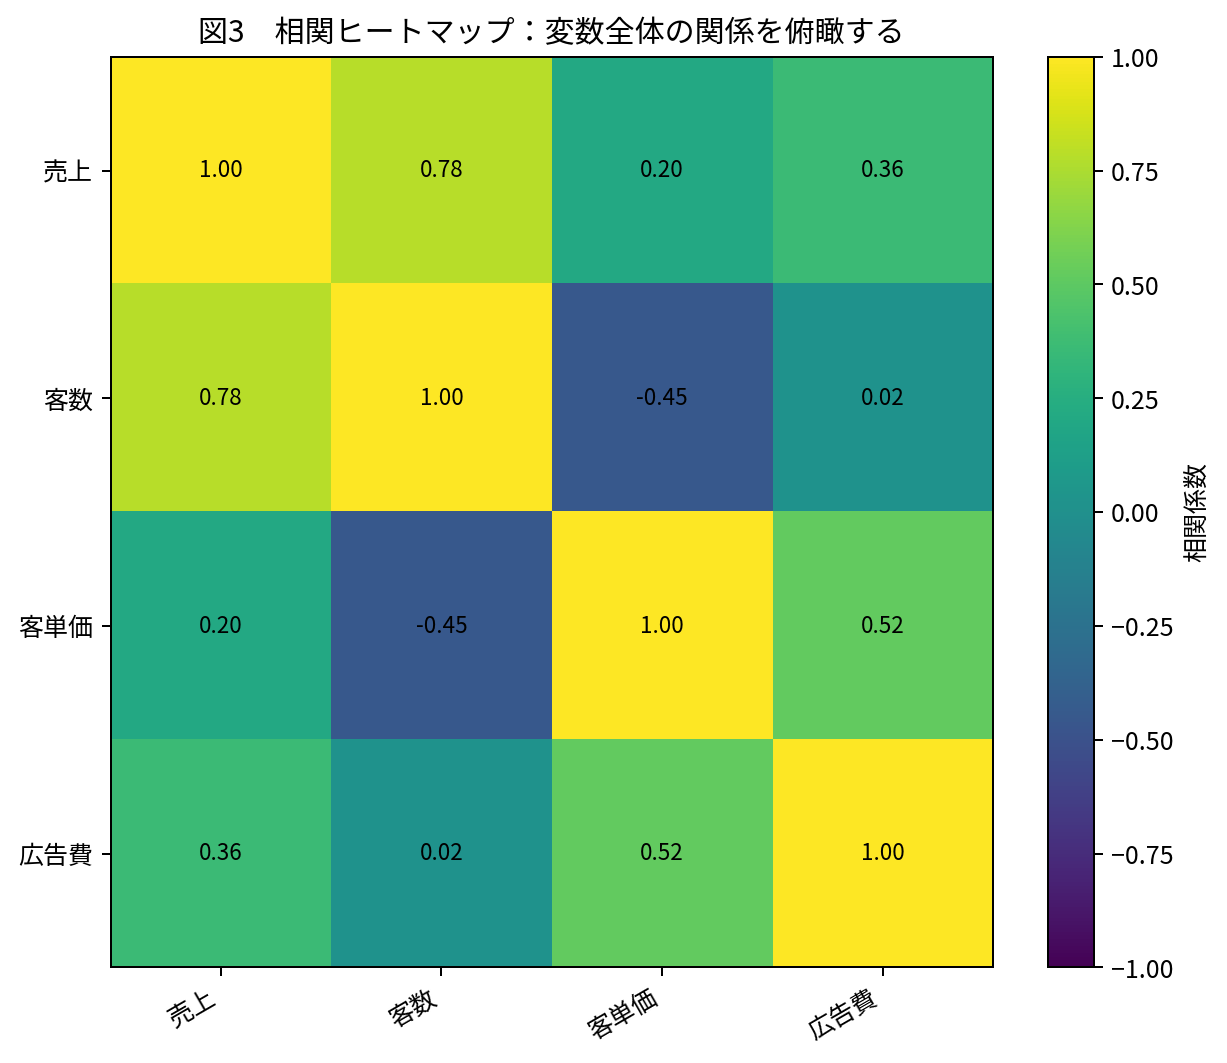
この例では、売上と客数の相関係数は0.78で、比較的強い正の関係があります。一方、客数と広告費は0.02で、ほとんど線形な関係がありません。
ただし、ヒートマップは個々の店舗を直接見るものではありません。たとえば店舗12の広告費が突出していることは、相関係数だけを見ても分かりません。また、相関係数だけでは非線形な関係や因果関係を判断できない点にも注意が必要です。
ここで扱うヒートマップは、多変量データの変数間関係を整理する相関ヒートマップです。Webページ上のクリック位置を示すアクセス解析のヒートマップとは目的が異なります。
Table Lens:大量の行を残したままパターンを探す
Table Lensは、大きな表を探索するために、表の文字情報とグラフィカルな表現を組み合わせる考え方です。本来は、注目部分を詳しく見ながら周囲の文脈も残すfocus+context型のインタラクティブな可視化として提案されています。
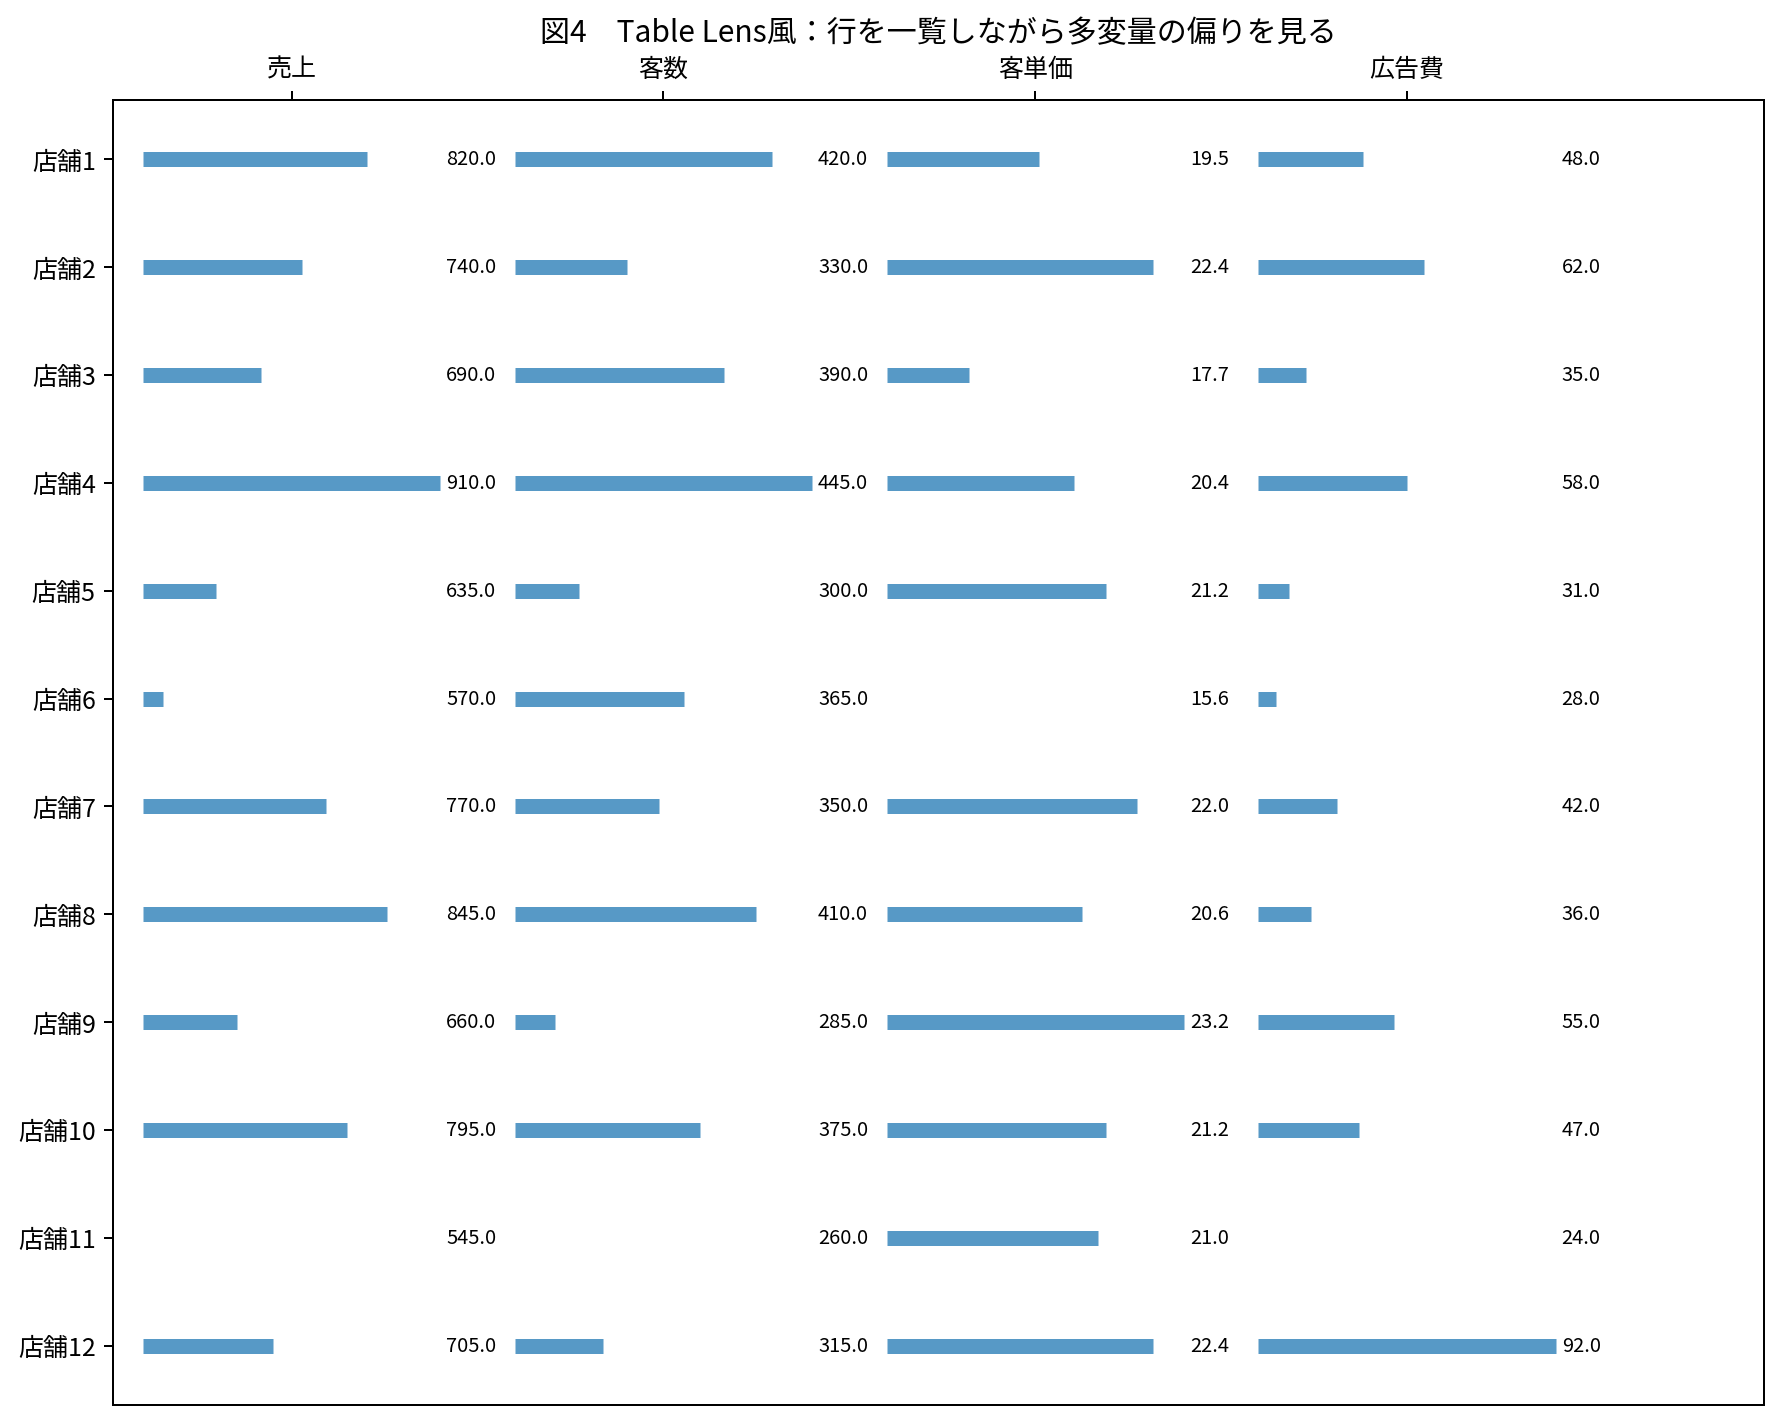
図4は本来のインタラクティブなTable Lensそのものではなく、考え方を静止画で説明するための模式図です。数値を残しつつ、各指標内で相対化したバーの長さでも大小を表すことで、店舗を行として保持したまま、どの指標が突出しているかを探せます。
たとえば店舗12では、広告費のバーだけが大きく伸びています。平行座標でも同じ特徴は見えますが、Table Lens型では元の「表の行」を保ったまま値を確認しやすいことが特徴です。
目的に応じた可視化手法の選び方
| 知りたいこと | 向いている手法 | 理由 |
|---|---|---|
| 1つの対象について複数指標の組み合わせを見たい | 平行座標 | 1対象を1本の線として全変数を追える |
| 変数ペアごとの関係や外れ値を詳しく見たい | 散布図行列 | 実際の点の分布を全ペアで確認できる |
| 変数全体の関係の強弱を素早く俯瞰したい | 相関ヒートマップ | 関係の強さを行列と色で比較できる |
| 多数の行を保持しながら特徴的な行を探したい | Table Lens | 表の構造を残しつつグラフィカルに比較できる |
迷ったときは、「対象ごとのプロフィール」「変数同士の関係」「変数全体の俯瞰」「行を残した探索」のどれを優先したいかで選ぶと整理しやすくなります。
1つの手法ですべてを理解しようとする必要はありません。まずヒートマップで関係の強い変数を探し、その組み合わせを散布図で詳しく確認するように、複数の可視化を組み合わせる方法も有効です。
多変量データを可視化するときの注意点
可視化は、データそのものを変えるわけではありません。同じデータでも、手法や軸の並べ方、正規化、色の設定によって見え方は変わります。
特に平行座標では変数の単位が異なると比較しにくいため、必要に応じて標準化や正規化を検討します。相関ヒートマップでは、色が強いからといって因果関係があるとは判断できません。散布図行列では、変数が多くなるほど図の数が増えるため、確認したい変数を絞ることも重要です。
「何を見つけたいのか」を先に決め、その目的に合った可視化を選ぶことが、多変量データを読み違えないための基本です。
まとめ
多変量データの可視化では、同じデータでも手法によって見える特徴が変わります。
- 平行座標は、対象ごとの複数指標の組み合わせを見る
- 散布図行列は、変数ペアごとの関係や外れ値を見る
- 相関ヒートマップは、変数全体の関係の強弱を俯瞰する
- Table Lensは、表の行を残しながら大量データを探索する
大切なのは、手法名を覚えることではなく、「何を知りたいか」に合わせて使い分けることです。必要に応じて複数の可視化を組み合わせると、1つの図だけでは見えない特徴を確認できます。
関連記事

