はじめに
写真に何が写っているかを判定したい場合と、写っている物体の位置や形まで知りたい場合では、適した画像認識のタスクが異なります。画像分類・物体検出・セグメンテーションは、いずれも画像を入力に使いますが、返す情報は同じではありません。
この記事では、「画像の種類」「物体の位置」「画素ごとの領域」という出力の違いを、同じ画像の例と比較表で整理します。どの情報が必要なときに、どのタスクを選ぶべきかを判断できることが目標です。
画像分類・物体検出・セグメンテーションの違い
結論から言うと、画像分類は画像全体の種類を答え、物体検出は物体の種類と位置を答え、セグメンテーションは画素単位の領域を答えます。 画像を詳しく調べるという目的は共通ですが、出力の細かさと表現形式が異なります。
| タスク | 何を調べるか | 主な出力 | りんごの画像での例 |
|---|---|---|---|
| 画像分類 | 画像全体がどの種類か | クラスラベル、必要に応じてクラスごとのスコア | 「りんご」 |
| 物体検出 | 何がどこにあるか | 物体ごとのラベルと位置を示す枠 | 「りんご」+画像内の四角い枠 |
| セグメンテーション | どの画素が何の領域か | 画素単位のラベルや領域マスク | りんごの輪郭に沿った領域 |
この表は代表的な出力を整理したものです。実際の出力項目はモデルや設定によって変わります。また、画像分類は画像内の物体の位置や形を直接示す処理ではありません。
画像分類:画像全体の種類を答える
画像分類(Classification)は、入力された画像全体に対して、学習済みのクラスの中からラベルを予測するタスクです。例えば、果物の画像を「りんご」「みかん」「バナナ」などへ分類します。モデルによっては、各クラスの予測スコアも返します。
画像を種類別に整理したり、製品画像を分類したりする用途に向いています。一方、複数の物体が写った画像を分類しても、それぞれの物体が画像のどこにあるかは通常分かりません。 一つのラベルを予測する分類と、複数ラベルを予測する分類もあるため、常に一画像一種類とは限らない点にも注意が必要です。
物体検出:位置と種類を答える
物体検出(Object Detection)は、画像内にある物体を見つけ、その種類と位置を予測するタスクです。一般的には、物体を囲む四角い枠(バウンディングボックス)とクラスラベルを組み合わせて出力します。
例えば、駐車場の画像から「車」を複数検出すると、車ごとに位置を示す枠が得られます。画像分類よりも「どこにあるか」を把握しやすいため、物体の個数を数えたり、画面内の配置を確認したりする場面に使えます。ただし、四角い枠は物体の大まかな位置を示すものであり、輪郭そのものや枠の内側のすべてが物体であることを保証するものではありません。
セグメンテーション:画素単位の領域を答える
セグメンテーション(Segmentation)は、画像内の領域を画素(ピクセル)単位で分けるタスクです。代表的なセマンティックセグメンテーションでは、画像の各画素に「りんご」「背景」などのクラスを割り当てます。結果は、どの画素が対象に当たるかを示す領域マスクとして表せます。
物体検出の四角い枠とは違い、領域の広がりや形を表せるため、道路と歩道の領域を分けたり、画像中の対象領域を取り出したりする場面に向いています。ただし、同じクラスの物体を一つずつ区別する必要がある場合は、個体ごとの領域を扱うインスタンスセグメンテーションなど、別の出力形式を選びます。
同じ画像を処理した場合の出力例
机の上にりんごが一つ写っている画像を考えてみましょう。画像分類なら「りんご」というラベルを予測します。物体検出なら、ラベルに加えてりんごを囲む四角い枠を返します。セグメンテーションなら、背景とりんごを画素単位で分けた領域を返します。
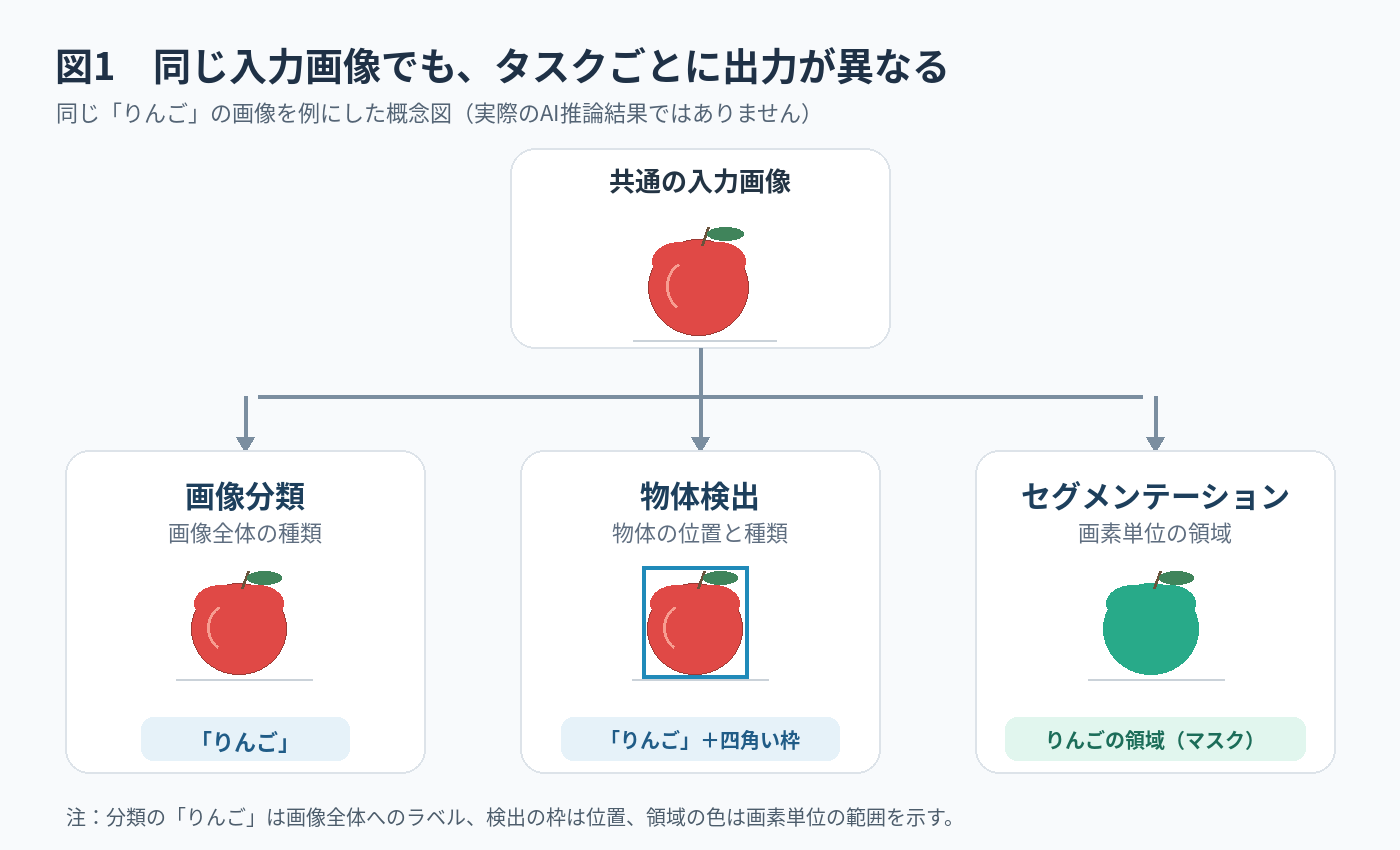
この例でも、画像全体の種類だけを知りたいなら画像分類、りんごの位置を知りたいなら物体検出、輪郭に沿った領域が必要ならセグメンテーションというように、求める出力に合わせて選びます。
目的に合わせた使い分け
「写真を種類別に振り分けたい」なら画像分類、「写真のどこに何があるかを知りたい」なら物体検出、「画素単位で対象の範囲を取り出したい」ならセグメンテーションが候補になります。最初に決めるのはモデル名ではなく、結果として必要な情報の形です。
なお、人の関節などの座標を推定する姿勢推定は、今回の3タスクと関連しますが、主な出力が関節位置などの点や骨格である別のタスクです。自動運転は一種類の画像認識タスクではなく、検出やセグメンテーションなどを必要に応じて組み合わせる応用分野です。両者を今回の3方式と同列の選択肢として扱う必要はありません。
実際のモデル利用では入力画像のサイズや画素値の調整も関係します。画像をモデルへ渡す前のリサイズ・パディング・正規化については、関連記事の「画像データ処理のリサイズ・パディング・正規化の特徴と実例解説」で扱います。
まとめ
画像分類・物体検出・セグメンテーションは、同じ画像を入力に使っても、出力する情報の種類が異なります。画像分類は種類、物体検出は種類と位置、セグメンテーションは画素単位の領域を扱うと整理できます。
モデルを選ぶときは「画像に何が写っているか」「物体はどこか」「どの画素が対象か」のうち、何に答えたいのかを先に明確にしましょう。迷ったときは冒頭の比較表と図1に戻ると、必要な出力を確認できます。
関連記事
- 画像データ処理のリサイズ・パディング・正規化の特徴と実例解説 — 画像認識モデルへ入力する前の前処理
- AI・機械学習とは?基礎から生成AI・MLOpsまで体系的に解説 — Theme全体の学習案内

